Explicación
Cómo hacen imágenes los modelos de difusión
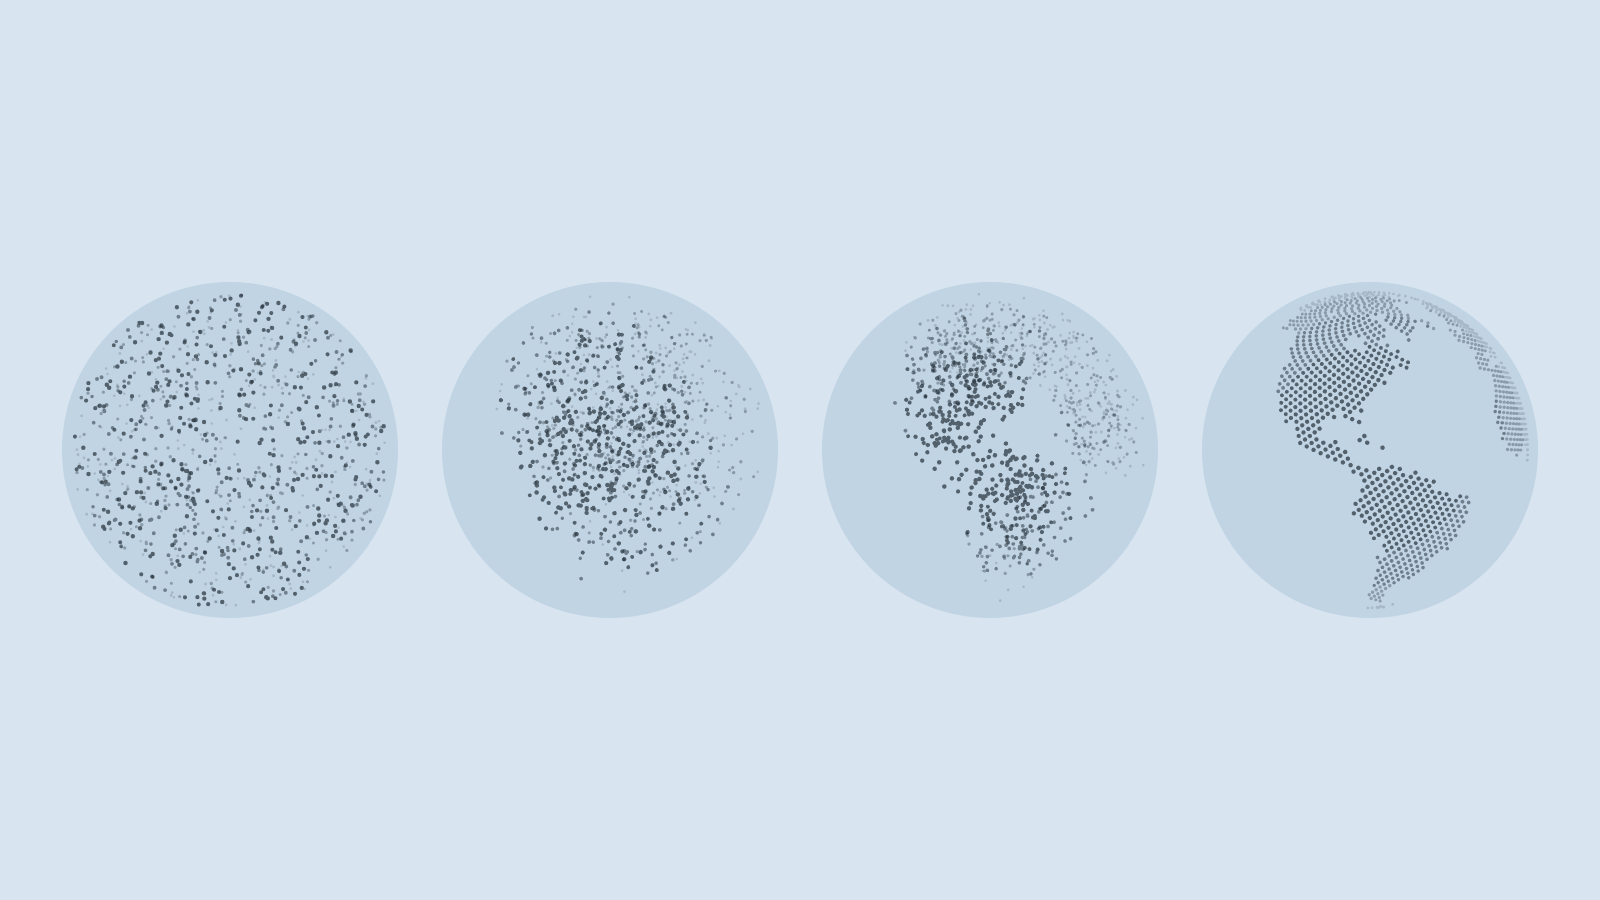
Escribes una frase en un generador de imágenes y unos segundos después aparece una imagen. Lo que pasa en medio es más fácil de seguir de lo que su fama sugiere, y empieza en un lugar curioso: al modelo lo entrenaron con imágenes arruinadas.
Aprender de imágenes arruinadas
Toma una fotografía y añádele un poco de ruido al azar, como la nieve de un televisor viejo. Añade más, y otra vez más. Después de suficientes rondas no queda nada de la fotografía.
Arruinar así una imagen no tiene ningún mérito. El entrenamiento está en el camino de vuelta. Al modelo le muestran una cantidad enorme de imágenes en cada etapa del deterioro, cada una con el texto que la describe, y le hacen siempre la misma pregunta: ¿qué ruido se añadió aquí? Su respuesta se compara con la verdad, y el modelo se ajusta.
Para responder bien tiene que aprender cómo son las imágenes: que un gato tiene dos orejas, que las sombras caen al lado opuesto de la lámpara, que el horizonte es recto. Nadie se lo escribe. Es, sencillamente, lo que un modelo necesita saber para distinguir una imagen del ruido que tiene encima.
Del ruido a la imagen
Para hacer una imagen nueva, al modelo le entregan ruido puro y lo trata como una imagen con ruido encima. Calcula ese ruido y quita una parte. El resultado es un poco menos aleatorio, así que vuelve a calcular y quita otro poco. Después de unas decenas de rondas hay una imagen.
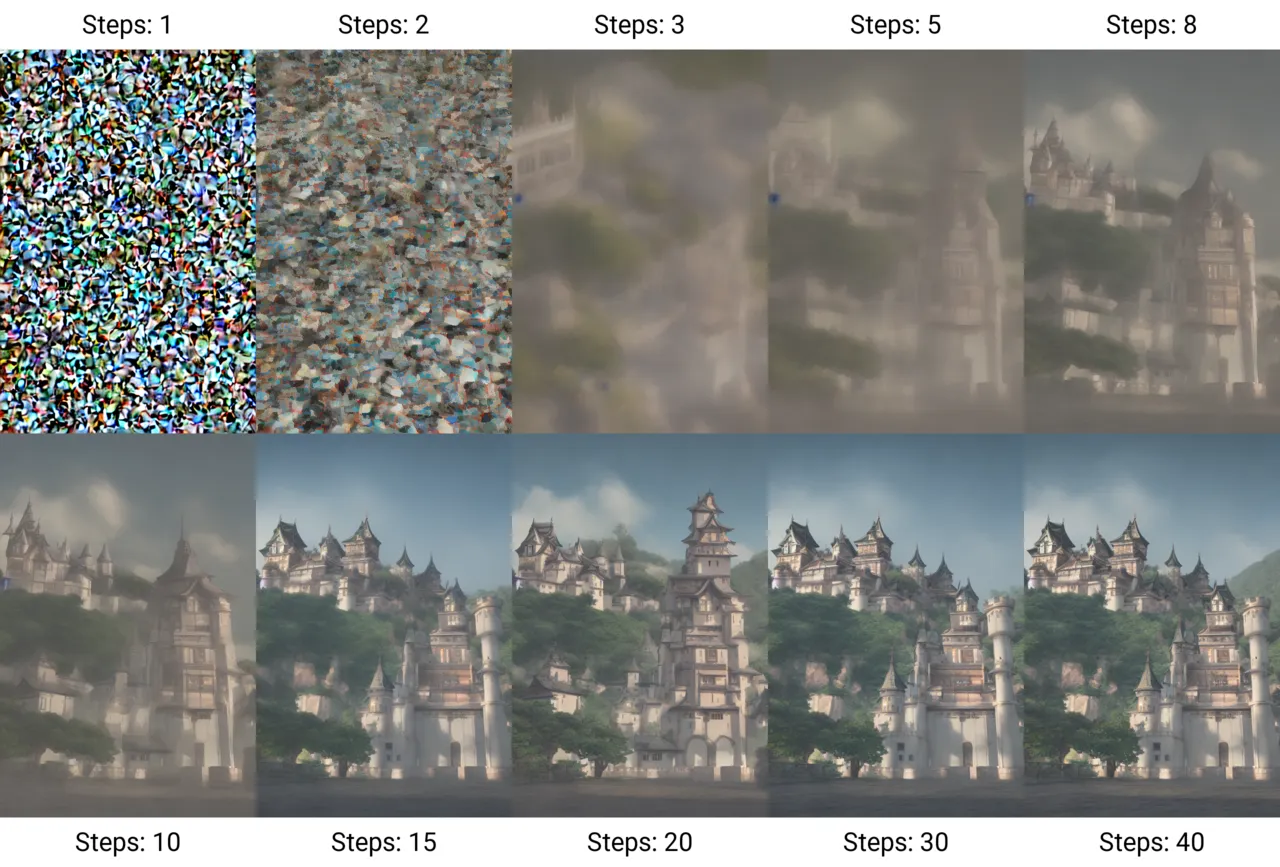

Las cosas aparecen siempre en el mismo orden. Los primeros pasos deciden la composición: dónde van las formas grandes, qué es claro y qué es oscuro. Los del medio convierten las formas en cosas. Los últimos solo añaden textura: hojas, pelo, el grano de una pared. Por eso una imagen detenida a mitad de camino parece una versión borrosa de la escena correcta, y no una imagen nítida de la escena equivocada.
El ruido del que parte lo elige un número llamado semilla. La misma semilla, el mismo prompt y los mismos ajustes dan la misma imagen, y así es como se reproduce un resultado y se va afinando. Otra semilla da otra imagen para las mismas palabras.
Dónde entra el prompt
Un segundo modelo lee primero el prompt y lo convierte en una lista de números que representa su significado. En cada paso, el modelo que quita el ruido recibe esos números junto con la imagen ruidosa, de modo que la pregunta que responde pasa a ser: ¿qué ruido tiene esta imagen de un faro al atardecer?
Por sí sola esa influencia es débil, y hay un truco para reforzarla. En cada paso el modelo hace dos cálculos, uno con el prompt y otro sin él, y luego avanza más en la dirección en que se diferencian. Cuánto más es el ajuste que casi todas las herramientas llaman escala de guía (guidance scale). Si es baja, la imagen se aleja de lo que pediste. Si es alta, sigue las palabras de cerca pero queda dura y sobresaturada.
El modelo que lee el prompt importa más de lo que parece. Los primeros generadores usaban uno pequeño que captaba la idea general y perdía el detalle, y por eso ignoraban la mitad de un prompt largo y no sabían escribir. Los más nuevos leen con modelos de lenguaje mucho más grandes, y con ellos llegaron en buena parte los prompts largos y los letreros legibles.
Por qué es lo bastante rápido
Una imagen de 1024 por 1024 píxeles son unos tres millones de números, y quitarles el ruido a todos decenas de veces sería lento. Por eso la mayoría de los generadores no trabajan con píxeles.
Otro modelo, entrenado de antemano, sabe comprimir una imagen en una cuadrícula de números mucho más pequeña y volver a desplegarla casi sin pérdida visible. Todo el trabajo de quitar ruido se hace en la cuadrícula pequeña, y el despliegue ocurre una sola vez, al final. En el primer Stable Diffusion una imagen de 512 píxeles se convertía en una cuadrícula de 64 por 64, con 48 veces menos números que procesar. Este diseño se llama difusión latente, y es la razón por la que estos modelos corren en una tarjeta gráfica corriente.
Qué ha cambiado desde entonces
La idea es la misma de 2022, y casi todas las piezas se han reemplazado. La red que calcula el ruido es ahora, por lo general, un transformer, el diseño de los modelos de lenguaje. Muchos modelos actuales se entrenan en una tarea algo distinta llamada flow matching: aprenden la dirección que lleva en línea recta del ruido a la imagen, que se recorre en menos pasos. Algunos se destilan después para necesitar apenas unos pocos pasos, y así es como una imagen puede aparecer mientras todavía escribes.
La misma receta se usa para video, donde el modelo quita el ruido de todos los fotogramas a la vez para que concuerden entre sí, y para sonido.
Lo que no hace
No busca en una biblioteca de imágenes ni pega trozos. En el modelo no se guarda nada más que sus números ajustados, y son demasiado pocos para contener las imágenes con las que se entrenó. Aun así, una imagen que apareció muchas veces en el entrenamiento puede volver a salir casi intacta, y esa es una de las razones por las que se sigue discutiendo con qué se entrenaron estos modelos.
Tampoco tiene contra qué revisar su trabajo. Sabe qué aspecto suelen tener las manos, y no sabe que una mano tiene cinco dedos. Por eso contar, escribir letras y todo lo que tiene que quedar exacto fue lo último en mejorar, y sigue siendo donde falla.